Аптамеры — короткие молекулы ДНК или РНК, способные избирательно связываться с малыми молекулами, белками и клетками. Благодаря этому их используют и изучают как основу для диагностических тестов, лекарственных препаратов и биосенсоров. Чтобы подобрать аптамер для конкретной мишени, исследователям приходится проверять множество вариантов. Компьютерные модели могут сократить число таких экспериментов, предварительно отбирая последовательности, которые с большей вероятностью будут работать. Но если модель плохо справляется с новыми вариантами, такой отбор может быть ненадежным.
Для решения этой проблемы исследователи ИТМО создали AptaBench — стандартный тест для ИИ-моделей, которые предсказывают взаимодействие аптамеров с молекулами. Он включает экспериментальные данные и единые правила проверки, чтобы можно было сравнивать результаты разных моделей. В базу данных AptaBench вошли 6 289 экспериментально подтвержденных пар взаимодействий, включающих 1 610 ДНК- и РНК-аптамеров и 942 лиганда. Работа принята на конференцию NeurIPS 2026 в трек Evaluations & Datasets.
«Многие модели для прогнозирования взаимодействий оцениваются в относительно простых условиях, когда обучающие и тестовые данные содержат похожие последовательности и молекулы. В реальных задачах нас часто интересует совершенно новая молекула или аптамер — например, последовательность, которую только что сгенерировала другая модель. Мы хотели понять, насколько результаты стандартного тестирования сохраняются в таких условиях. Оказалось, что разница может быть весьма существенной. Поэтому важно оценивать не только точность модели, но и границы ее применимости», — комментирует Мария Еремеева, первый автор статьи и инженер передовой инженерной школы ИТМО.
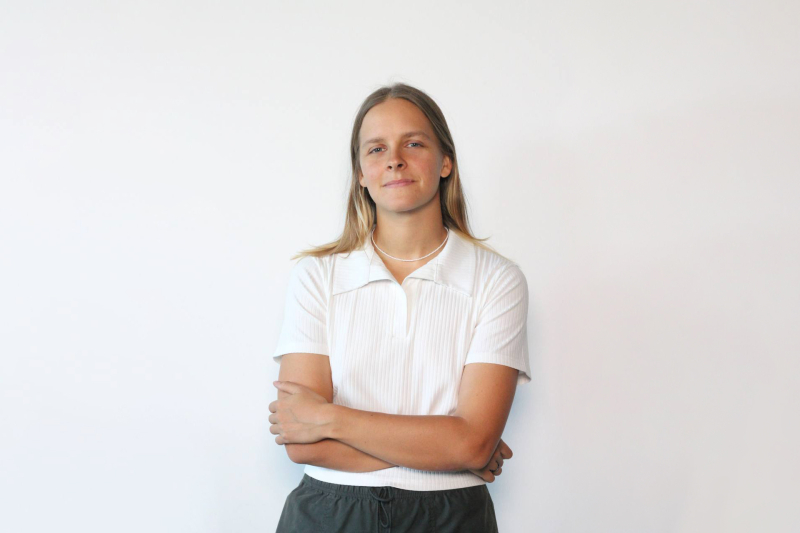
Мария Еремеева. Фото: Полина Федорова / ИТМО
Для AptaBench исследователи собрали только те случаи, когда взаимодействие аптамера и молекулы было проверено экспериментально. В том числе в набор вошли пары, для которых эксперимент показал, что аптамер не связывается с молекулой или связывается с ней очень слабо. Это важно, поскольку в предыдущих исследованиях отрицательные примеры часто создавались искусственно — без экспериментальной проверки. Сравнение показало, что реальные данные лучше помогают модели учиться: в одном из экспериментов показатель PR-AUC, который характеризует качество такого распознавания, вырос с 0,75 при использовании искусственных отрицательных примеров до 0,95 при использовании экспериментальных данных.
Исследователи также предложили три способа проверить модель. В первом случае данные случайным образом разделяются на обучающие и тестовые — так обычно оценивают качество моделей. Во втором модель проверяют на новых молекулах, которые отличаются по химическому строению от тех, на которых она училась. В третьем — на новых семействах аптамеров, то есть последовательностях, которых не было среди близких вариантов в обучающих данных. Такой подход позволяет проверить, сможет ли модель работать с действительно новыми объектами, а не только с похожими на уже знакомые.
Результаты показали заметную разницу. При стандартной проверке показатель ROC-AUC, который отражает способность модели отличать связывающиеся пары от несвязывающихся, составил 0,95. При работе с молекулами нового химического строения он снизился до 0,89, а с новыми семействами аптамеров — до 0,87. При прогнозировании силы связывания используется другой показатель — R²: он показывает, насколько близки прогнозы модели к экспериментальным значениям. В этом случае показатель снизился примерно с 0,67 до 0,30.
Полученные результаты показывают, что высокая точность модели на стандартном тесте еще не гарантирует, что ей можно доверять при поиске новых аптамеров. AptaBench дает исследователям единый способ проверить это до начала практического применения модели. Помимо самого набора данных, авторы предоставили готовый код для его обработки и базовые модели для сравнения результатов.
В дальнейшем авторы планируют использовать AptaBench при разработке алгоритмов, которые будут создавать новые аптамеры под заданные молекулы. В таком подходе AptaBench поможет проверять, насколько надежны модели, которые оценивают созданные последовательности, прежде чем наиболее перспективные из них отправятся на экспериментальную проверку.
Работа выполнена в рамках федеральной программы академического лидерства «Приоритет 2030».