Многие научные задачи ученые решают с помощью нейросетей и программного кода: результаты расчетов часто оформляют в виде программ, которыми потом пользуются другие исследователи. Поэтому написанный для исследования код — такой же результат работы, как и сама статья. Но в отличие от публикации, найти код и понять, кто его автор, бывает сложно: репозитории могут быть размещены на личных аккаунтах, ссылки в статьях бывают искажены, а имена авторов в материалах — указаны по-разному. Поэтому, чтобы найти нужный инструмент для вычислений или коллегу с подходящей компетенцией, ученым приходится вручную просматривать публикации, связываться с другими подразделениями и организациями или обращаться к нейросетям, которые не всегда имеют доступ к нужным сайтам и не связывают разрозненные сведения в единую картину.
Для решения этой задачи ученые Института искусственного интеллекта ИТМО разработали первый в России открытый инструмент для построения графа знаний PAUK, который связывает организацию, сотрудника, публикацию и код. Название сервиса было выбрано из-за схожести карты связей с паутиной — его система позволяет дотянуться до данных, которые обычные нейросети не находят, например, репозитории с кодом. При этом сведения в сервисе строятся по «правилам доказательности».
«Главное отличие PAUK от обычного автоматического парсинга в том, что система не просто угадывает связи, а на каждом этапе ищет им подтверждения. Например, чтобы убедиться, что в разных статьях упоминается один и тот же человек, системе недостаточно одного лишь совпадения по имени — она сверяет ORCID (международный идентификатор ученого) или институциональную почту. Это нужно, чтобы не спутать его с другим человеком, так как в разных статьях имя может быть записано по-разному — “Иванов Иван” и “Иванов И.” Бывает и так, что код, упомянутый в статье, написан не ее автором, поэтому система отдельно проверяет, действительно ли сотрудник является создателем этого кода, а не просто ссылается на чужой инструмент. Если доказательств не хватает, решение откладывается или передается на ручную проверку — это помогает избежать ошибок, когда из-за обрезанного списка авторов сотрудники института исчезают из статистики его публикаций и разработок или чужой инструмент цитируется как собственный», — объяснил младший научный сотрудник исследовательского центра в сфере искусственного интеллекта «Сильный искусственный интеллект в промышленности» ИТМО, руководитель команды разработки Андрей Гетманов.
Андрей Гетманов. Фото: Мила Маньшина
PAUK будет полезен для разных целей:
- Ученым — чтобы находить коллег с нужными компетенциями для совместной работы, прослеживать связи между коллективами и использовать открытый код;
- ИИ-агентам — чтобы по статье с описанием метода находить сам код, модель или датасет и не дублировать уже существующие разработки;
- Руководству научных организаций — чтобы видеть реальную картину: кто действительно пишет код, а не только статьи, и где находятся скрытые эксперты, которых не видно в обычных отчетах по публикациям.
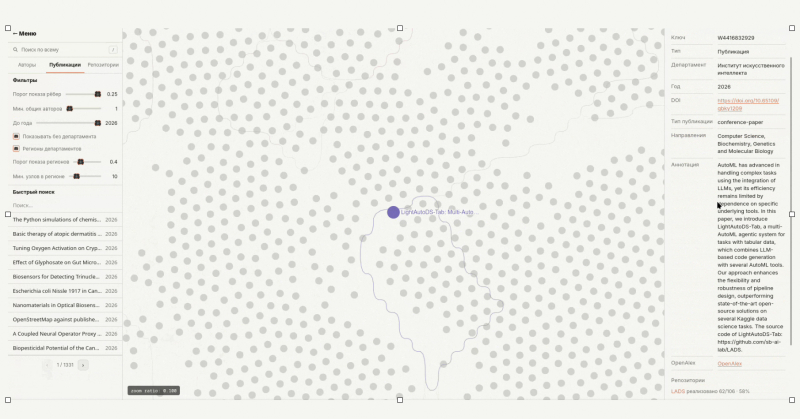
Карточка публикации ИТМО. Изображение предоставлено разработчиками.
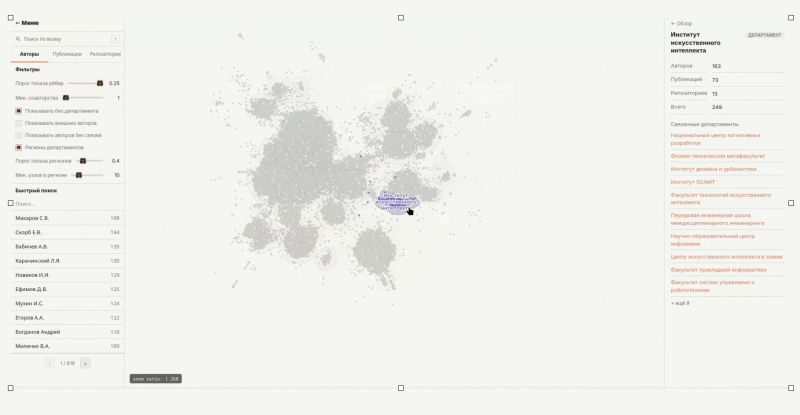
Департамент на общей карте. Изображение предоставлено разработчиками.
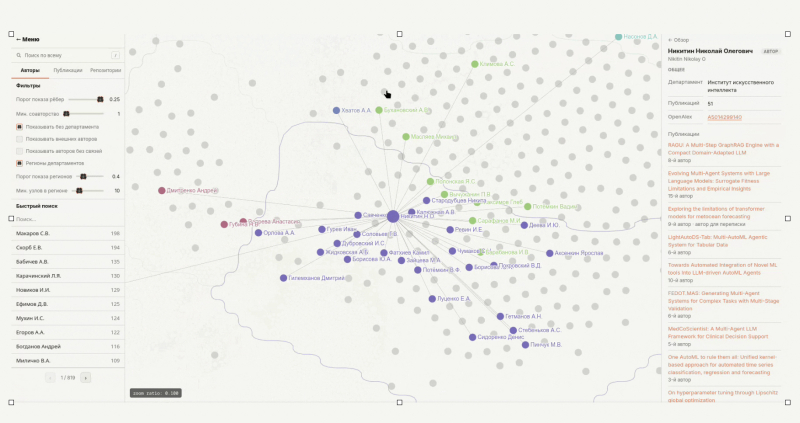
Карточка сотрудника ИТМО и его связи с другими сотрудниками. Изображение предоставлено разработчиками.
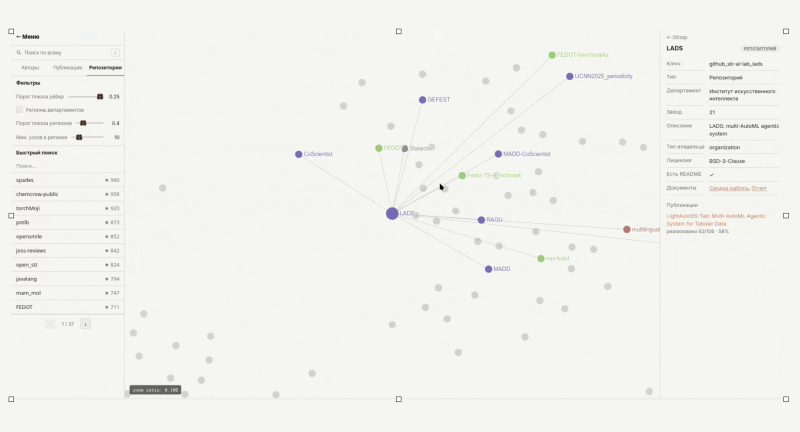
Карточка репозитория ИТМО и его связи с другими репозиториями. Изображение предоставлено разработчиками.
Чтобы по одному названию найти саму статью и все, что с ней связано, PAUK выполняет несколько шагов. Сначала система берет данные из OpenAlex — открытой базы научных статей — и выбирает публикации, связанные с запросом. Затем она ищет в этих статьях ссылки на GitHub или другие сайты с кодом и оставляет только те работы, где есть код или хранилище кода. После этого система сама чистит и обрабатывает данные, например извлекает ссылки из статей в PDF, где они бывают обрезаны или перенесены с пробелами. Также PAUK сверяет авторов по открытым данным. На выходе пользователь получает связанную картину: статью, ее авторов, их подразделения и код, который к этой работе относится.
«PAUK сильно упрощает поиск нужных людей и инструментов для совместной работы. Представьте, что научной группе химиков нужно найти специалистов, которые занимаются мультиагентными системами. Раньше им пришлось бы выходить на связь с другим факультетом университета, узнавать, кто именно этим занимается, просматривать списки публикаций и искать контакты — на это уходило много времени. Теперь химики могут просто сделать запрос в PAUK и получить структурированный ответ с именами, статьями, репозиториями и ссылками», — рассказал Андрей Гетманов.
Сейчас PAUK работает на внутренних серверах ИТМО. В дальнейшем разработчики планируют открыть доступ к сервису и расширить список источников — например, добавить материалы неархивных воркшопов и конференций по открытому коду. Кроме того, разработчики хотят добавить возможность задавать вопросы обычным языком, а не только по указанию точного названия статьи или имени. Также в графе появятся сведения об участии ученых в конференциях и об источниках финансирования. В будущем команда планирует адаптировать подход для других вузов, чтобы упростить поиск партнеров и организацию совместной деятельности.
Работа поддержана внутренней программой «ИТМО 2030». Над проектом работала команда из 12 сотрудников и студентов Института искусственного интеллекта, включая студентов первых курсов бакалавриата из учебно-научной лаборатории АИСТ. Сервис представили на XXII конференции разработчиков свободного ПО, которая проходила 2–4 октября в Переславле-Залесском.